
常見算法優缺點
1.樸素貝葉斯
樸素貝葉斯屬于生成式模型(關于生成模型和判別式模型,主要還是在于是否是要求聯合分布),非常簡單,你只是做了一堆計數。如果注有條件獨立性假設(一個比較嚴格的條件),樸素貝葉斯分類器的收斂速度將快于判別模型,如邏輯回歸,所以你只需要較少的訓練數據即可。即使NB條件獨立假設不成立,NB分類器在實踐中仍然表現的很出色。它的主要缺點是它不能學習特征間的相互作用,用mRMR中R來講,就是特征冗余。引用一個比較經典的例子,比如,雖然你喜歡BradPitt和TomCruise的電影,但是它不能學習出你不喜歡他們在一起演的電影。
優點:
· 樸素貝葉斯模型發源于古典數學理論,有著堅實的數學基礎,以及穩定的分類效率。
· 對小規模的數據表現很好,能個處理多分類任務,適合增量式訓練;
· 對缺失數據不太敏感,算法也比較簡單,常用于文本分類。
缺點:
· 需要計算先驗概率;
· 分類決策存在錯誤率;
· 對輸入數據的表達形式很敏感。
2.LogisticRegression(邏輯回歸)
屬于判別式模型,有很多正則化模型的方法(L0,L1,L2,etc),而且你不必像在用樸素貝葉斯那樣擔心你的特征是否相關。與決策樹與SVM機相比,你還會得到一個不錯的概率解釋,你甚至可以輕松地利用新數據來更新模型(使用在線梯度下降算法,onlinegradientdescent)。如果你需要一個概率架構(比如,簡單地調節分類閾值,指明不確定性,或者是要獲得置信區間),或者你希望以后將更多的訓練數據快速整合到模型中去,那么使用它吧。
Sigmoid函數:
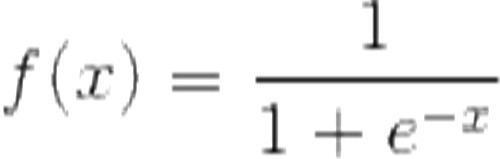
優點:
· 實現簡單,廣泛的應用于工業問題上;
· 分類時計算量非常小,速度很快,存儲資源低;
· 便利的觀測樣本概率分數;
· 對邏輯回歸而言,多重共線性并不是問題,它可以結合L2正則化來解決該問題;
缺點:
· 當特征空間很大時,邏輯回歸的性能不是很好;
· 容易欠擬合,一般準確度不太高
· 不能很好地處理大量多類特征或變量;
· 只能處理兩分類問題(在此基礎上衍生出來的softmax可以用于多分類),且必須線性可分;
· 對于非線性特征,需要進行轉換;
3.線性回歸
線性回歸是用于回歸的,而不像Logistic回歸是用于分類,其基本思想是用梯度下降法對最小二乘法形式的誤差函數進行優化,當然也可以用normalequation直接求得參數的解,結果為:

而在LWLR(局部加權線性回歸)中,參數的計算表達式為:

由此可見LWLR與LR不同,LWLR是一個非參數模型,因為每次進行回歸計算都要遍歷訓練樣本至少一次。