
1.背景介紹
由于 FPGA 具備可編程和高性能計算的特點,基于FPGA硬件的AI計算加速,正廣泛地應用到計算機視覺處理領域。其中極具代表性的部署方式之一就是使用FPGA和CPU組合構成異構計算系統,并在CPU上搭載Linux操作系統,運行AI推理引擎框架及視頻圖片處理等各種業務。其中,如何協調CPU和FPGA的計算關系,成為這套異構系統的關鍵,而這部分關鍵技術則是由驅動系統來完成的。
協調CPU和FPGA這對異構兄弟的計算關系,可以有許多模式,根據不同的應用場景會有很大的變化。一般在端側,整個系統的應用比較單一可控,較少考慮并發及虛擬的情形。根據這一情況,EdgeBoard應運而生。
2.EdgeBoard介紹
EdgeBoard是百度打造的基于FPGA的嵌入式AI解決方案及基于此方案實現的系列硬件。作為端側的解決方案,沒有在PL側為FPGA設計專用的內存,而是采用了PS和PL側共用DDR內存的結構。因此,對這種異構系統的CPU和FPGA的協調就落在了內存的管理方面,這就是驅動系統中關于內存管理的子系統。
3.全文概述
本文將重點介紹EdgeBoard中關于CPU和FPGA內存驅動設計的關鍵技術。下圖是整體EdgeBoard的軟件框架圖,其中內存驅動位于內核部分。下面將從內存的分配、釋放、回收等方面來逐步介紹。

4.內存的特點和FPGA的內存需求
在FPGA芯片PS側,CPU使用多級緩存來訪問DDR,在Linux操作系統中,使用內存映射頁面(通過頁表來管理),而對DDR的物理連續性沒有要求,它們被映射到虛擬連續的地址空間中。而在PL側的FPGA一般未使用任何緩存機制,它們在計算中都是直接訪問DDR。每一次讀寫操作都是讀或寫一個連續的內存空間,而且要求這片內存的起始地址要對齊在一個特定的地址偏移處(偏移0x10)。一次計算中的多次讀寫都要求訪問的DDR是一致連續的。
針對CPU和FPGA這樣的內存需求,我們設計Linux驅動內存的子系統時,就要充分考慮到:1)cache的影響;2)FPGA使用內存的物理連續性;3)傳遞給FPGA使用的內存塊要滿足偏移要求(segment alignments)。
5.保留系統內存
針對上述需求,我們采用分隔物理內存的設計方案,從整體系統中保留其中的一部分內存,讓Linux只使用另一部分內存。這部分被保留的內存,分配權歸內存驅動,驅動從保留部分中分配的內存塊在Linux系統中和FPGA系統中都可以訪問。在此期間,分配時要保證物理連續和起始偏移特性,使其能滿足FPGA的需求。
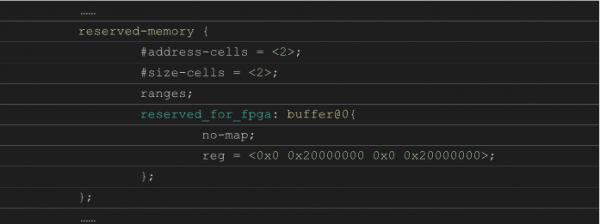
在EdgeBoard實踐中,我們采用的是Xilinx的ZynqMP系列的FPGA芯片,使用PetaLinux工具鏈來編譯Linux內核,并采用DeviceTree中的reserved-memory節點來實現內存的保留。例如,系統總體2GB內存,保留1GB給FPGA,留下1GB給Linux操作系統,DeviceTree中相關節點的設定就是這樣的:
下面就從驅動設計實現的各個方面介紹。
6.初始化內存的內部映射
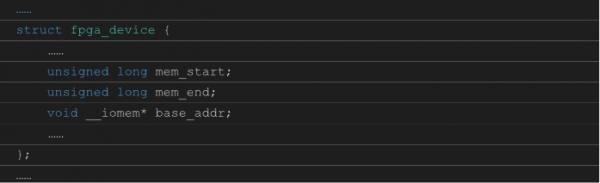
FPGA總體設備驅動是采用字符設備platform driver的形式來編寫的:在Device的probe階段,對驅動內所保留的內存塊做好內存映射(memremap),并使用合理的數據結構,保存好各個參數,以供后續使用。例如:

mem_start、mem_end、base_addr 等結構成員的定義如下:
7.內存的分配
關于內存的分配,采用了mmap調用的方式:在FPGA設備的初始化期間,初始化字符設備時傳遞了file_operations結構變量,這個結構變量的mmap指針初始化為我們的內存分配函數。
內存分配中,我們使用了內核提供的bitmap數據結構,來管理我們保留的內存區域——bitmap位數組中的每一位代表著16k的一個內存塊,另外還使用相同長度的數組來管理內存被分配的客戶owner(即file指針)、內存分配的塊的數量等信息。
另外,在分配的內存對應的vma(VMM Memory Area)中,我們還注冊了自己的私有數據private data來記錄對應內存的必要信息:如對應內存塊的總線物理地址范圍和映射地址、bitmap位數組的索引等,用于地址轉換;再如對應內存塊的一些finger信息,用來標識保留內存塊。
同時,我們也為VMA的vm_ops注冊了close函數,用于為對該塊內存的回收做好準備。
關于內存分配的代碼量較大,這里就不一一列舉了。
8.內存的回收
已分配出去的內存塊都需要回收,其中有兩種最具代表性的情況,一種是用戶release一塊內存的處理,另一種則是用戶關閉設備時對未release的內存塊的清理回收。
當用戶release一個內存塊時,對應的vma的close函數會被自動執行。為此,我們注冊這個函數作為內存釋放處理函數:函數實現中,首先檢測private data避免錯誤處理,然后恢復對應的bitmap位數組中的位信息,清理owner和塊數量信息,使得這塊保留內存又回到了待分配的狀態。
當用戶關閉設備時,會調用設備注冊的release函數。因此,在設備的release函數中,我們遍歷owner數組來清理owner與設備的file指針相同的內存塊,以此達到批量回收的目的。
9.內存的地址轉換
內存的地址轉換,是完成總線物理地址和虛擬邏輯地址的雙向轉換,為內存cache的flush/invalidate、以及交由FPGA之時要進行的處理等提供支撐。系統也通過兩個IOCTL向用戶層暴露這兩個轉換操作。
地址轉換操作中,首先找到對應的vma,然后計算出offset,最后檢查vma對應的標識是不是保留的內存塊——如果是,就使用我們vma保存的private_data中的信息及offset完成相關的計算。
10.內存緩存的flush和invalidate操作
在CPU及其異構兄弟FPGA之間,使用DDR內存來傳送數據時,需要使用flush或invalidate來消除對應緩存的影響。
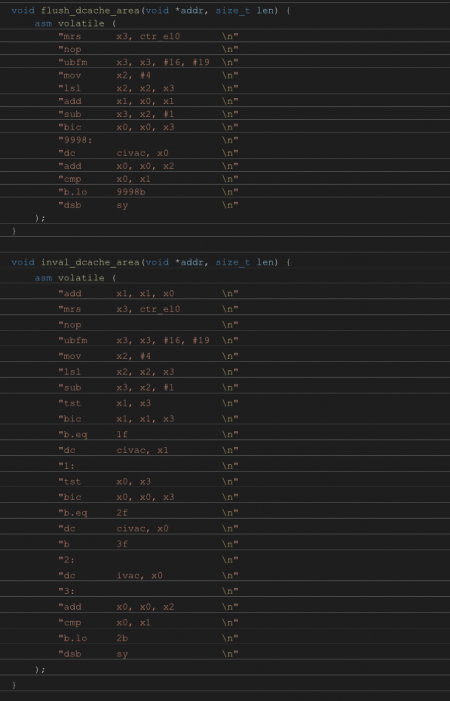
首先,我們的驅動代碼是運行在CPU上面的,當針對一片內存的處理從CPU轉移到FPGA之前,需要對這片內存的cache執行flush操作,使得內存cache中的所有改動都寫入到DDR,然后FPGA開始對它的處理工作。其次,當針對一片內存的處理從FPGA轉移到CPU之前,需要對這片內存的cache執行invalidate操作,使得cache內容無效,下次CPU直接讀取即從DDR中去主動load從而刷新cache。這樣,CPU就可以很好地跟FPGA相處了。
對于flush和invalidate操作,則是CPU體系相關的。EdgeBoard使用的是A53v8(對應于AArch64執行集),cache flush和invalidate的代碼如下:
11.內存驅動中其它功能設計及考慮
上文中提到的保留內存區域中每個保留內存塊的大小是16K,其實這里是可以啟用多規格的,這樣用戶在使用上就會更加方便,用途也會更多。但是關于內存管理部分就需要更多的數據來進行管理了。
另外,我們可以通過建立一些IOCTL的方式為不同進程之間的內存共享做出一些快速、簡潔的方案,這也是我們可以在內存驅動中設計考慮的。