
編者按:Hyena,是由斯坦福大學(Stanford University)和加拿大 MILA 人工智能研究所(MILA institute for AI)的人工智能科學家于 2023 年 3 月首次提出的一項技術,堪稱比 GPT-4 或任何同類 AI 技術都高效。本文來自編譯,希望能對你有所啟示。
名為 Hyena(意為“鬣狗”)的新型技術,可達到與使用注意力機制的 GPT-4 同等的準確性,但使用的算力比后者減少了 100 倍。
盡管 Open AI 推出的人工智能聊天機器人 ChatGPT 及其最新一代人工智能語言模型 GPT-4 引起了全球范圍內的轟動,但說到底,這些語言模型只是軟件應用程序。與所有應用程序一樣,它們也有技術限制。
今年 3 月,斯坦福大學(Stanford University)和加拿大 MILA 人工智能研究所(MILA institute for AI)的人工智能科學家聯合發表了一篇論文,并提出了一種新技術(Hyena)。此項技術甚至比 GPT-4 或任何類似 AI 技術都要高效,它可以吸收大量數據并將其轉化為用戶想要的答案。
這項被稱為 Hyena 的技術只使用其一小部分計算能力,就能夠在問答等基準測試中達到與 GPT-4 同等的準確性。在某些情況下,Hyena 能夠處理大量的文本,而 GPT-4 每次最多只能處理不超過 25000 個單詞。
谷歌的科學家 Ashish Vaswani 和他的同事于 2017 年發表了一篇名為《Attention Is All You Need》(《注意力就是你的全部所需》)的論文,它在人工智能研究領域具有里程碑的意義。該論文對 Transformer 模型(一種神經網絡結構)作了十分詳細的介紹,一個基于 Transformer 的可訓練的神經網絡可以通過堆疊 Transformer 的形式進行搭建,擅長處理語言理解任務,所需計算能力更少。作者在論文中寫道:“基于十億參數級模型的運行結果顯示,注意力可能并不是我們所需要的全部。”Transformer 潛力巨大,目前已成為了許多大型語言模型的基礎,比如 ChatGPT。
但是 Transformer 神經網絡模型有一個很大的缺陷,當它處理大量的輸入信息時需要借鑒人腦的“注意力機制”,即只選擇一些關鍵信息輸入進行處理,以此提高神經網絡的效率。
這種注意力機制具有“二次型計算復雜性”,其時間和存儲復雜度在序列長度上屬于二次型,處理長文本序列的能力很差,這種內在缺陷是包括 ChatGPT 和 GPT-4 在內的所有大型語言程序都具備的。這種二次復雜性意味著 ChatGPT 產生答案所需的時間會隨著輸入數據量的增多而增加。
在某種程度上,如果提示內容輸入過多,要么程序無法提供答案,要么它必須具備足夠的計算能力才能滿足運行需求,從而導致人工智能聊天機器人計算需求激增。
在 the arXiv pre-print server(由美國國家科學基金會和美國能源部資助,在美國洛斯阿拉莫斯國家實驗室建立的免費電子預印本文獻庫)上發布的新論文《Hyena 層次結構:邁向更大的卷積語言模型》(Towards Larger Convolutional Language Models')中,斯坦福大學的主要作者 Michael Poli 和他的同事建議使用“次二次函數”,即 Hyena 來取代 Transformer 的注意力函數。
作者并沒有解釋“Hyena”的名字由來,但人們大致可以想象出各種緣由。Hyena,又譯為“鬣狗”,它是一種生活在非洲的動物,可以捕獵數英里。從某種意義上說,一個非常強大的語言模型可以像鬣狗一樣,為了尋找“答案”而處理數以萬計的文本內容。
但正如標題所示,作者真正關心的是“等級制度”。鬣狗家族有一個嚴格的等級制度,一般來說鬣狗女王最高貴,其次是幼崽,地位最低的是雄性鬣狗。鬣狗女王領導并且支配著整個族群,享有最高的地位,這樣的“等級制度”確立了鬣狗女王的統治地位。正如你將看到的那樣,Hyena 程序會以某種類似的方式一次又一次地應用一系列非常簡單的操作,將它們結合起來形成一種數據處理的層次結構。正因為如此才給這個程序起名“Hyena”。
這篇論文的特約作者有眾多來自人工智能領域的杰出人士,比如加拿大 MILA 人工智能研究所的科學主任約書亞·本吉奧(Yoshua Bengio),他是 2019 年圖靈獎(相當于計算機領域的諾貝爾獎)的獲得者。早在 Vaswani 及其團隊將注意力機制應用于 Transformer 之前,本吉奧就因開發了注意力機制而廣受贊譽。斯坦福大學計算機科學副教授 Christopher Ré 也是作者之一,他近年來幫助推動了人工智能作為“軟件 2.0”的概念。
為了找到注意力機制“二次型計算復雜性”的替代方案,Poli 及其團隊開始研究注意力機制是如何發揮作用的。
人工智能科學領域最近的一項被稱為機械可解釋性(mechanistic interpretability)的實踐研究正在深入了解神經網絡內部結構,即注意力機制是如何運作的。你可以把它想象成拆開一臺電腦,看看它的各個組件部分,并弄清楚它是如何工作的。
波利及其團隊引用的是人工智能初創公司 Anthropic 的研究員尼爾森·埃爾哈格(Nelson Elhage)的一系列實驗,這些實驗對 Transformer 的算法結構進行了全局分析,從根本上理清了 Transformer 在處理和生成文本時的工作內容是什么,并深入探究了其背后注意力機制的工作原理。
從本質上講,埃爾哈格和他的團隊發現,注意力在最基本的層面上是通過非常簡單的計算機操作來發揮作用的。假設給定一個輸入,“Teacher Judy is so busy……because Teacher X…”,X 指向“Judy”。注意力機制就是查看上下文中的最后一個單詞“Teacher”,并在上下文中搜索與最后一個單詞相關聯的特定單詞,再將這個關聯單詞作為模型輸出。
再比如,如果一個人在 ChatGPT 中輸入《哈利波特與魔法石》(Harry Potter and the Sorcerer's Stone)中的一句話,比如“Mr. Dursley was the director of a firm called Grunnings…”,那么只要輸入“D-u-r-s”,這個名字的開頭,可能就足以提示程序完成“Dursley”這個名字,因為它在《哈利波特與魔法石》這本書中看到過這個名字。系統能夠從記憶中復制字符“l-e-y”的記錄來自動完成句子的輸出。
然而,隨著單詞數量的增多,注意力機制會遇到二次復雜性問題。更多的文本需要更多的“權重”或參數來運行。
正如作者所寫:“Transformer 塊是序列建模的強大工具,但它并非沒有局限性。其中最值得注意的是計算成本,隨著輸入序列內容長度的增加,計算成本會迅速增長。”
雖然 OpenAI 尚未披露 ChatGPT 和 GPT-4 的技術細節,但據悉它們可能有一萬億或更多這樣的參數。運行這些參數需要更多的 GPU 芯片,從而增加了計算成本。
為了降低二次計算成本,Poli 和團隊用所謂的“卷積模型”替代了注意力機制,這是人工智能程序中最古老的運算模型之一,早在 20 世紀 80 年代就進行了改進。卷積模型等同于一個過濾器,可以從數據中挑選出項目,無論是圖片像素還是文本格式均支持。
Poli 和他的團隊做了一種混合研究,即將斯坦福大學研究員 Daniel Y. Fu 及其團隊所做的工作與阿姆斯特丹自由大學的學者 David Romero 及其同事的研究結合起來,讓該程序可以動態改變濾波器大小。這種靈活適應的能力減少了程序需要的參數或權重的數量。
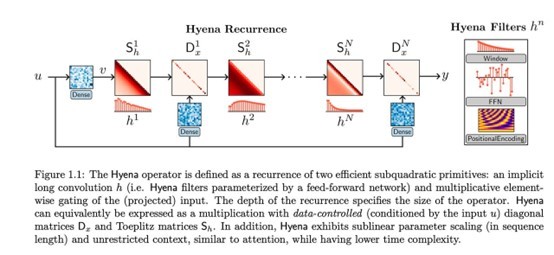
Hyena 模型是卷積過濾器的組合,每一個卷積層中使用的過濾器中的參數都是一樣的。它們彼此建立在一起,而不會引起神經網絡參數的大量增加。
卷積模型可以應用于無限量的文本,而不需要越來越多的參數來保證程序的運行。正如作者所說,這是一種“不需要集中注意力”的方法。
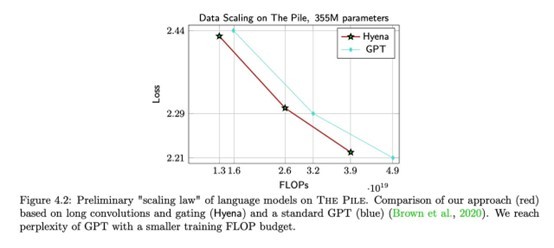
Poli 及其團隊寫道:“Hyena 能夠顯著縮小與注意力機制的差距,以較小的算力預算來解決同等的困惑。”
為了證明 Hyena 的能力,作者根據一系列基準測試了該程序,這些基準決定了一個語言程序在各種人工智能任務中的表現。
其中一個測試是 The Pile,這是一個由非營利人工智能研究機構 Eleuther.ai 在 2020 年收集的包含有 825 GiB 的開源語言建模數據集。這些文本是由 22 個較小的高質量數據集組合而成的,比如 PubMed、arXiv、GitHub、美國專利局等,相比其他數據集更專業。
該程序面臨的主要挑戰是,當輸入一堆新句子時,如何生成一個新單詞。研究人員寫道,從 2018 年開始,在計算運行操作減少 20% 的前提下,Hyena 能夠達到與 OpenAI 原始 GPT 程序相當的準確性。它是第一個與 GPT 質量相匹配的無注意力機制的卷積模型。
接下來,作者在被稱為 SuperGLUE 的推理任務上測試了該程序,該任務是 2019 年由紐約大學、Facebook 人工智能研究、谷歌 DeepMind 部門和華盛頓大學的學者共同推出的。
例如,當給定“我的身體在草地上投下陰影”這個假設,并給出造成這一現象的兩種原因:“太陽升起來了”或“草被割了”,并要求程序選擇其中一種合理原因時,其會將“太陽升起來了”作為輸出文本。
在處理多任務時,Hyena 模型的得分達到了或接近 GPT 版本的分數,然而其使用的訓練數據不及 GPT 的一半。更有趣的是,當作者想試試增加輸入字符串長度時會有何變化,結果發現:字符越多,其表現就越好,所需時間就越少。
Poli 和團隊認為,他們不僅對 Hyena 嘗試了不同的方法,還解決了二次計算復雜性的難題,使程序計算結果的難度發生了質的變化。
他們認為,在未來的道路上,打破二次計算障礙是邁向深度學習的關鍵一步,例如使用整本教科書作為上下文提示,來創作長段音樂或處理十億像素級圖像。
作者寫道,Hyena 能夠使用一個可以更有效地擴展成千上萬個單詞的過濾器,這意味著查詢語言程序的上下文實際上沒有限制,它甚至可以回憶起文本或先前對話的內容。
他們提出,Hyena 不受人為限制,并且可以學習“輸入提示”中的任何元素。此外,除了文字,該程序還可以應用于不同形式的數據,例如圖像,也許還有視頻和聲音。
值得注意的是,與 GPT-4 甚至 GPT-3 相比,論文中顯示的 Hyena 程序規模較小。GPT-3 有 1750 億個參數或權重,而 Hyena 最多只有 13 億個參數。因此,Hyena 在與 GPT-3 或 GPT-4 進行全面比較時的表現還有待觀察。
但如果 Hyena 程序在更大規模層面的應用上也被證明是高效的話,這一程序會廣泛流行開的——媲美注意力機制在這過去十年中所達到的那種流行程度。
正如 Poli 及其團隊總結的那樣:“更簡單的二次模型,如 Hyena,基于一套簡單的指導原則和機械可解釋性基準,將可以成為大型高效語言模型的基礎。”
譯者:Araon_
璀璨的燈光下,一身銀黑涂裝的智能機器人“小科”手持話筒,邁著穩健的步伐走上舞臺。“一城秋色一城新,萬縷和風萬縷誼。在這個九月,我們跨越山海、相聚于此,共同開啟‘2026面向東盟國際技術轉移與創新合作大......
璀璨的燈光下,一身銀黑涂裝的智能機器人“小科”手持話筒,邁著穩健的步伐走上舞臺。“一城秋色一城新,萬縷和風萬縷誼。在這個九月,我們跨越山海、相聚于此,共同開啟‘2026面向東盟國際技術轉移與創新合作大......
《國民健康“十五五”規劃》明確提出,要以“治病為中心”加速轉向“以健康為中心”,增設睡眠健康門診并推進數字化主動健康管理。在此背景下,玖治科技(RingConn)與瑞思邁(Resmed)于近日在上海簽......
《國民健康“十五五”規劃》明確提出,要以“治病為中心”加速轉向“以健康為中心”,增設睡眠健康門診并推進數字化主動健康管理。在此背景下,玖治科技(RingConn)與瑞思邁(Resmed)于近日在上海簽......
近日,中國農業科學院農業資源與農業區劃研究所聯合華中師范大學、華中農業大學、國際應用系統分析研究所(IIASA)、國際食物政策研究所(IFPRI)等國內外科研機構,研發了全球30米高精度耕地遙感產品H......
近日,中國農業科學院農業資源與農業區劃研究所聯合華中師范大學、華中農業大學、國際應用系統分析研究所(IIASA)、國際食物政策研究所(IFPRI)等國內外科研機構,研發了全球30米高精度耕地遙感產品H......
記者9月15日獲悉,“閩港科創面對面”——2026閩港人工智能與智慧醫療創新技術合作專場活動日前在福建廈門舉行,合作專場共簽約5個閩港科創合作項目,集中發布38項閩港兩地人工智能與智慧醫療領域科創成果......
記者9月15日獲悉,“閩港科創面對面”——2026閩港人工智能與智慧醫療創新技術合作專場活動日前在福建廈門舉行,合作專場共簽約5個閩港科創合作項目,集中發布38項閩港兩地人工智能與智慧醫療領域科創成果......
近日,因AI公司宣布其模型解決了一個數學界經典難題,陶哲軒、鄧煜等25位菲爾茨獎獲得者隨后聯名發布公開信提出警示,引發輿論嘩然,熱度綿延至今。人工智能驅動的科學研究已勢不可擋,科學家該如何與AI做好配......
近日,因AI公司宣布其模型解決了一個數學界經典難題,陶哲軒、鄧煜等25位菲爾茨獎獲得者隨后聯名發布公開信提出警示,引發輿論嘩然,熱度綿延至今。人工智能驅動的科學研究已勢不可擋,科學家該如何與AI做好配......