
簡要給大家介紹一下語音怎么變文字的吧。希望這個介紹能讓所有同學看懂。
首先,我們知道聲音實際上是一種波。常見的 mp3、wmv 等格式都是壓縮格式,必須轉成非壓縮的純波形文件來處理,比如 Windows PCM 文件,也就是俗稱的 wav 文件。wav 文件里存儲的除了一個文件頭以外,就是聲音波形的一個個點了。下圖是一個波形的示例。
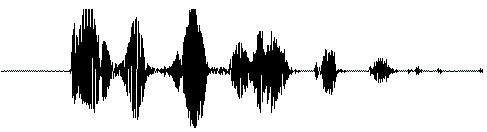
在開始語音識別之前,有時需要把首尾端的靜音切除,降低對后續步驟造成的干擾。這個靜音切除的操作一般稱為 VAD,需要用到信號處理的一些技術。
要對聲音進行分析,需要對聲音分幀,也就是把聲音切開成一小段一小段,每小段稱為一幀。分幀操作一般不是簡單的切開,而是使用移動窗函數來實現,這里不詳述。幀與幀之間一般是有交疊的,就像下圖這樣:
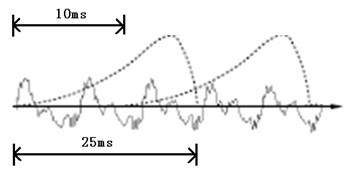
圖中,每幀的長度為 25 毫秒,每兩幀之間有 25-10=15 毫秒的交疊。我們稱為以幀長 25 ms、幀移 10 ms 分幀。圖中,每幀的長度為 25 毫秒,每兩幀之間有 25-10=15 毫秒的交疊。我們稱為以幀長 25 ms、幀移 10 ms 分幀。
分幀后,語音就變成了很多小段。但波形在時域上幾乎沒有描述能力,因此必須將波形作變換。常見的一種變換方法是提取 MFCC 特征,根據人耳的生理特性,把每一幀波形變成一個多維向量,可以簡單地理解為這個向量包含了這幀語音的內容信息。這個過程叫做聲學特征提取。實際應用中,這一步有很多細節,聲學特征也不止有 MFCC 這一種,具體這里不講。
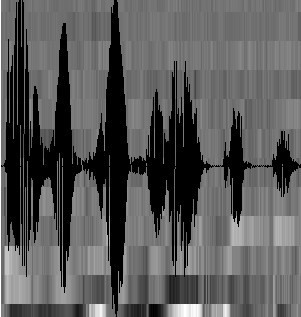
至此,聲音就成了一個 12 行(假設聲學特征是 12 維)、N 列的一個矩陣,稱之為觀察序列,這里 N 為總幀數。觀察序列如下圖所示,圖中,每一幀都用一個 12 維的向量表示,色塊的顏色深淺表示向量值的大小。
接下來就要介紹怎樣把這個矩陣變成文本了。首先要介紹兩個概念:
1.音素:單詞的發音由音素構成。對英語,一種常用的音素集是卡內基梅隆大學的一套由 39 個音素構成的音素集,參見 The CMU Pronouncing Dictionary。漢語一般直接用全部聲母和韻母作為音素集,另外漢語識別還分有調無調,不詳述。
2.狀態:這里理解成比音素更細致的語音單位就行啦。通常把一個音素劃分成 3 個狀態。
語音識別是怎么工作的呢?實際上一點都不神秘,無非是:
第一步,把幀識別成狀態(難點);
第二步,把狀態組合成音素;
第三步,把音素組合成單詞。
如下圖所示:
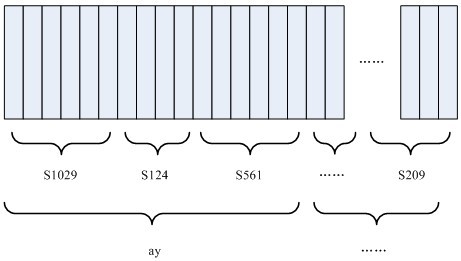
圖中,每個小豎條代表一幀,若干幀語音對應一個狀態,每三個狀態組合成一個音素,若干個音素組合成一個單詞。也就是說,只要知道每幀語音對應哪個狀態了,語音識別的結果也就出來了。圖中,每個小豎條代表一幀,若干幀語音對應一個狀態,每三個狀態組合成一個音素,若干個音素組合成一個單詞。也就是說,只要知道每幀語音對應哪個狀態了,語音識別的結果也就出來了。