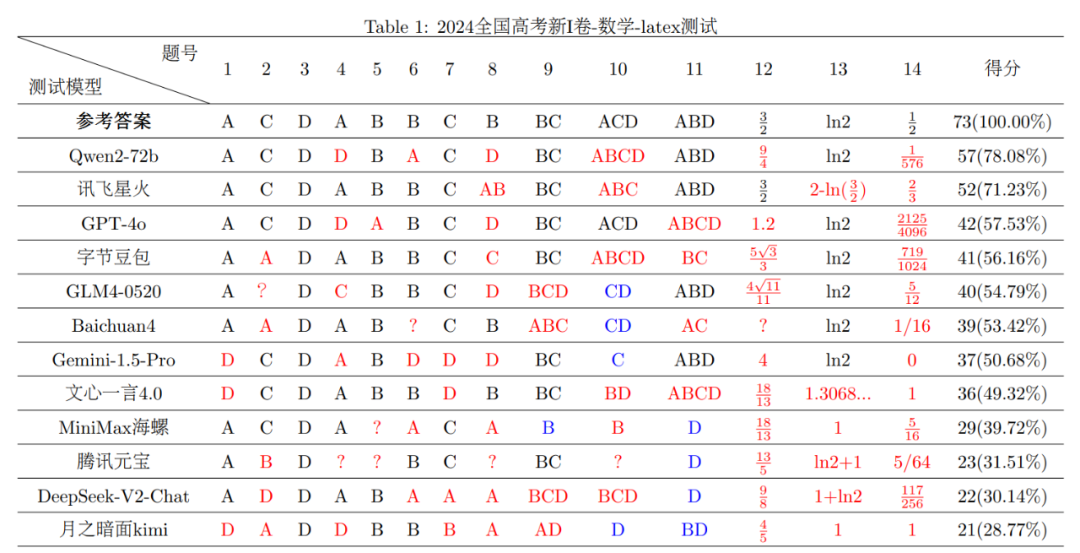
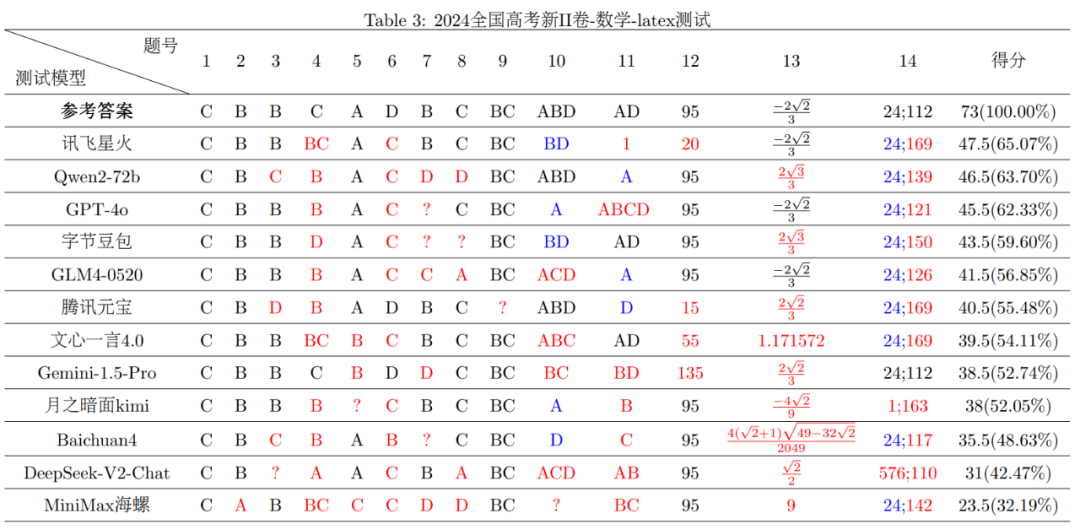
2024年全國高考的“硝煙”剛剛散去不久,“大模型考生”就被抓回來重新“做題”了。市面上涌現出的大模型產品讓人眼花繚亂,圍繞“大模型技術哪家強”的討論不絕于耳,各色名目的大模型評測應運而生。作為國內最權威的考試之一,高考覆蓋各類學科及題型,同時在開考前屬于“絕密”,非常適合用來作為考查大模型智能水平的評測工具,堪稱大模型綜合能力的“試金石”。連日來,一些專業機構紛紛下場,使用市面上常見的大模型產品如通義千問、字節豆包、訊飛星火、文心一言、騰訊元寶、Kimi等作為“考生”,圍繞“大模型高考測試”得出了一系列結果,為人們更好地了解大模型產品的性能和特點提供了參考樣本。近期,一則“AI高考測試出分,數學全不及格”的消息登上“熱搜”。消息出自上海人工智能實驗室旗下司南評測體系OpenCompass對7個開源大模型進行的高考“語數外”全卷能力測試。據OpenCompass于6月19日發布的評測結果,大模型的語文、英語考試水平還不錯,但數學都不及格,最高分也只有75分(滿分150分)。參加OpenCompass此次高考測試的大模型,分別來自阿里巴巴、零一萬物、智譜AI、上海人工智能實驗室、法國Mistral的開源模型。OpenCompass稱,因無法確定閉源模型的更新時間,此次評測沒有納入商用閉源模型,僅引入GPT-4o作為評測參考。對于數學測試全部不及格,OpenCompass表示,“大模型在數學方面還有很大的提升空間”。不過,復旦大學自然語言處理(NLP)實驗室LLMEVAL團隊主持的高考數學評測顯示,大模型數學成績不佳的結果,可能緣于“打開方式不對”。首先,LLMEVAL團隊選取了2024年高考新I卷、新II卷數學試卷的客觀題(單選、多選和填空題,共73分)來評測,得出了不同的結論。使用客觀題測試大模型的好處是,對就是對,錯就是錯,結果一目了然。同時主觀題由于解題方法、思路存在差異,具有一定的主觀性,如果結果不正確,很難客觀地評出步驟分。其次,此次大模型“考生”增加到12個:阿里巴巴Qwen2-72b、訊飛星火、GPT-4o、字節豆包、智譜GLM4-0520、百川智能Baichuan4、谷歌Gemini-1.5-Pro、文心一言4.0、MiniMax海螺、騰訊元寶、月之暗面Kimi、DeepSeek-V2-Chat。另外,他們在評測中發現,數學問題的不同格式的提示輸入(Prompt)對大模型性能影響很大。在最初的評測中,LLMEVAL團隊對數學題目中的公式部分采用了通過光學字符識別(OCR)后輸出的格式(轉義符格式),最新一次評測則使用了Latex格式進行了橫向對比評測。結果顯示,大多數模型兩次測試結果出現較大差異,不過使用Latex格式后,大模型整體表現更佳:2024年全國高考新I卷、新II卷數學測試中,得分率超過50%的大模型產品數量由此前的5個和6個升至7個和9個。考慮到Latex格式更符合人類實際使用大模型時所采用的格式,LLMEVAL團隊建議后續測試主要基于此格式。具體而言,LLMEVAL團隊使用Latex格式Prompt的測試結果顯示,在2024全國高考新I卷數學測試中,阿里巴巴Qwen2-72b、訊飛星火的得分率均超過及格線(60%),分別為78.08%和71.23%;在2024年全國高考新II卷數學測試中,訊飛星火、阿里巴巴Qwen2-72b和GPT-4o的得分率也超出了及格線,分別為65.07%、63.70%、62.33%。

Latex格式Prompt測試結果。來源:復旦大學NLP實驗室由此可見,大模型在數學方面并非熱搜所說那般完全不及格,訊飛星火、阿里巴巴Qwen2-72b等國產大模型在高考數學客觀題中具有較高的準確率,令人眼前一亮。當然,LLMEVAL團隊在評測后也指出,大模型在數學推理任務中的魯棒性與準確性仍有很大的提升空間。“AI考生”之于語文、英語高考,最引人矚目的當數大模型的作文水平了。對于考生而言,作文考試主要考查學生運用語言成文的能力,考查的是識字情況、用詞組句的能力以及表達事實、思想或觀點的能力。事實上,作文也是最能考驗大模型語言理解能力和文本生成能力的測評工具,這兩項能力正是時下大模型最為倚重的。2024年全國高考語文科目考試一結束,就有不少場外師生使用市面上的大模型產品“寫作文”。圍繞新課標I卷高考作文題“答案與問題”、新課標II卷“抵達未知之境”、北京高考(1)(2)卷的作文題“歷久彌新”和“打開”等題目,文心一言、訊飛星火等多家大模型產品紛紛化身“寫手”,并紛紛交出“作品”。一些大模型作文令人眼前一亮。以全國新高考I卷的作文題為例,在這個具有思辨性的題目引導下,大模型提交的部分作文題不僅切題,更顯巧妙,如《問,豈可少?》《疑問如春芽,答案似剪刀》《于無疑處生疑,方是進矣》《問題不止,智慧無窮》《智涌未來,問海無涯》,等等。近日,全國中小學生作文競賽評委、中學語文教研專家呂政嘉和河南省基礎教育教學專家庫成員李來明共同對市面上7款大模型產品的上述4張試卷的作文進行了評測打分。從打分情況來看,訊飛星火、文心一言4.0、騰訊元寶在4張試卷的作文題上均有不俗表現,最高平均得分接近50分。能拿50分的AI作文長啥樣?訊飛星火作出的《問,豈可少?》得到均分51.5的評分。李來明對該文的評語為,“全文結構完整,思路清晰,論證層層遞進,結構框架清晰明了。全文多處扣題生發議論,鞭辟入里,分析得當。但在一些地方,可以適當增加一些論證手法,使文章更加生動有趣。”在高考英文作文題目“幫李華寫郵件”中,中國外語教育研究中心特約研究員、知名教研策劃專家周國榮和廣東國家級示范校教師楊菁菁也對上述7款大模型產品的英語作文進行了評測和打分。他們將2024年高考真題作文要求輸入7款大模型產品,生成作文后,由教研雙評產生評分和最高分點評。全國高考卷的英語應用文寫作題中,7款大模型產品均能完成試題規定的寫作任務,結構上也能做到邏輯清晰、結構合理。其中不乏作品能夠使用復雜句式,在語言表達上有多處亮點。但這些文章也有一些明顯的扣分項,如使用超綱詞匯、超過字數上限等。打分方面,7款產品均有超過12分(滿分15分)的表現,且得分相對穩定。在難度更高的全國高考英語卷“讀后續寫”題目和北京卷英語作文題中,7款大模型產品的表現開始有了差別。周國榮和楊菁菁的打分和點評顯示,訊飛星火、騰訊元寶在“讀后續寫”題目中高分領先;在北京卷英語作文題中,訊飛星火、Kimi、文心一言4.0排前三位。綜合來看,國產大模型在中國高考的表現并不落下風,有著教育行業背景的訊飛星火大模型還在一眾大模型中表現搶眼,堪稱“更會做題的大模型”。評測作為對機器理解、處理、應用自然語言能力的一種評估和量化手段,是大模型領域技術水平和研究進展的直觀體現,是相關研究的工具和重要驅動力。北京大學計算語言學研究所教授穗志方在日前“大模型+計算語言”專題論壇上的報告中表示,大模型在人類標準化考試中如中國高考、公務員考試、美國SAT考試等的表現,能夠為其在真實世界中的能力提供評估參考,但仍存在一些問題。如一些模型在諸如SAT數學測試等任務中表現優異,但在復雜推理或特定知識領域中的表現卻又不夠出色。截然相反的表現,讓人無從評判。“在大模型內在機理沒有探究清楚的情況下,我們目前的評測路徑只能依靠從外部表現來推測內在能力。”穗志方說,現有評測仍存在規范性、系統性及科學性方面的問題,評測的深度和廣度方面有待改進。她提出,未來大模型評測應當以具有綜合考查能力的類人機器語言能力評測為目標,在參考信度、難度、效度三大原則的基礎上,應發展更系統的評測大綱、更具挑戰的評測任務、更科學的評測方法,采取更多樣、更魯棒的評測手段,科學高效地為大模型提供客觀、公平、類人的評測結果。如此,方能引領和推動人工智能領域各類模型、方法的提出和創新。